Progetti Dascos
Sistemi reali, problemi reali, architetture verificabili.
Questa sezione raccoglie progetti effettivamente realizzati: infrastrutture aziendali, alta disponibilità, software e componenti di sicurezza. Il filo comune è il lavoro sul sistema nel suo insieme, non sul singolo pezzo.
INFRA
Reti, server, identità, backup e continuità vengono progettati come parti dello stesso ambiente.
HA
Ridondanza e failover devono essere verificabili, non soltanto dichiarati.
APP
Software e API risolvono flussi operativi concreti e devono restare manutenibili nel tempo.
SEC
La sicurezza entra nell’architettura, dal segmento di rete fino al reverse proxy.
Case study
Quattro progetti, quattro modi diversi di tenere insieme i pezzi.
Le schede rimandano agli approfondimenti completi. Facchin Gru, BnB Genius e Tiny.top sono casi reali documentati; Reactive Web Firewall rappresenta invece il lato R&D/Engineering nato dall’esperienza operativa.
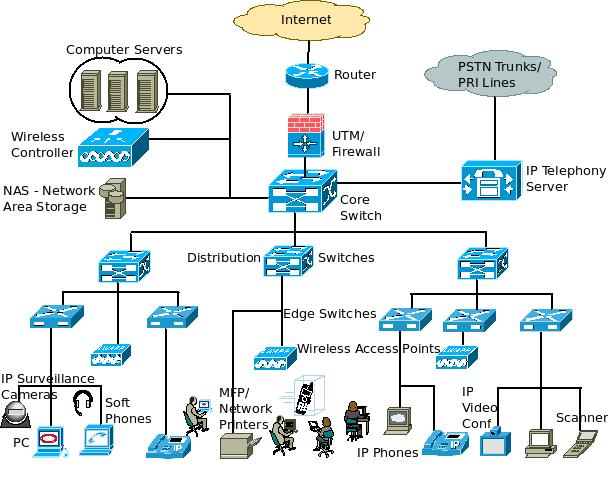
Facchin Gru · evoluzione dell’infrastruttura IT
CLIENTE / INFRASTRUTTURA
Dalla LAN Gigabit a dominio Windows, DNS, backup, segmentazione, firewall, VoIP, videosorveglianza e ponte radio tra sedi. Un progetto cresciuto per fasi senza trasformarsi in una collezione di reti separate.
BnB Genius · High Availability & Load Balancing
CLIENTE / HIGH AVAILABILITY
Tre server con frontend di bilanciamento, due backend, replica MySQL master-master, sincronizzazione dei file e ridondanza dello storage. Il case study storico registra 620 giorni consecutivi di funzionamento.
Tiny.top · URL shortening, API e Csd
PRODOTTO / WEB APPLICATION
Un servizio web per creare e gestire short link con statistiche, password, scadenze, domini personalizzati e API. È anche una prova concreta del riuso di Csd fuori dai gestionali tradizionali.
Reactive Web Firewall · difesa reattiva sul reverse proxy
R&D / SECURITY
Un componente nato per trasformare probe web ad alta confidenza in un blocco immediato: Apache, helper privilegiato, nftables e propagazione opzionale fino al firewall OpenWrt di frontiera.
Metodo
Dal problema operativo alla soluzione che resta gestibile.
01
Analisi
Si ricostruiscono dipendenze, vincoli e punti fragili prima di cambiare configurazioni.
02
Disegno
Si definiscono architettura, separazioni, integrazioni e percorso di migrazione.
03
Test
Le modifiche vengono verificate per fasi e, quando possibile, osservate prima del go-live.
04
Attivazione
Il passaggio in produzione deve prevedere continuità, rollback e responsabilità chiare.
05
Evoluzione
Monitoraggio e comportamento reale guidano le modifiche successive.
Cosa accomuna questi progetti
Nessuno vive dentro un solo livello tecnico.
Anche quando il punto di partenza è una rete, un portale o un redirect, prima o poi entrano in gioco dati, sicurezza, continuità, monitoraggio e modalità operative. È lì che il progetto smette di essere una semplice installazione.
Integrazione
Rete, sistemi e software devono sapere l’uno dell’altro quando condividono lo stesso processo.
Osservabilità
Log e metriche servono prima del guasto, non soltanto durante l’emergenza.
Ridondanza
Backup e failover hanno valore solo se il percorso di recupero è noto e verificabile.
Manutenibilità
Una soluzione deve poter essere capita e modificata anche mesi dopo la messa in produzione.
Il risultato che interessa
Meno punti ciechi e meno rimbalzi tra fornitori.
Il valore non è aggiungere tecnologia. È ridurre le zone in cui nessuno sa davvero chi controlla cosa, perché un servizio dipende da un altro o dove guardare quando compare un problema.
Responsabilità chiare
Ogni componente deve avere un ruolo comprensibile nel sistema.
Confini espliciti
Segmenti, servizi e privilegi vengono separati dove serve davvero.
Percorsi di recupero
Backup, failover e fallback devono avere una logica prima dell’incidente.
Evoluzione progressiva
Quando possibile, l’infrastruttura cresce senza ricominciare ogni volta da zero.
Hai un progetto che attraversa più sistemi?
Partiamo dal punto in cui oggi si crea più attrito.
Rete, server, applicazioni, telefonia e sicurezza spesso si influenzano a vicenda. Prima di scegliere cosa comprare o sostituire, ricostruiamo il quadro tecnico.